 4 Min. Lesezeit
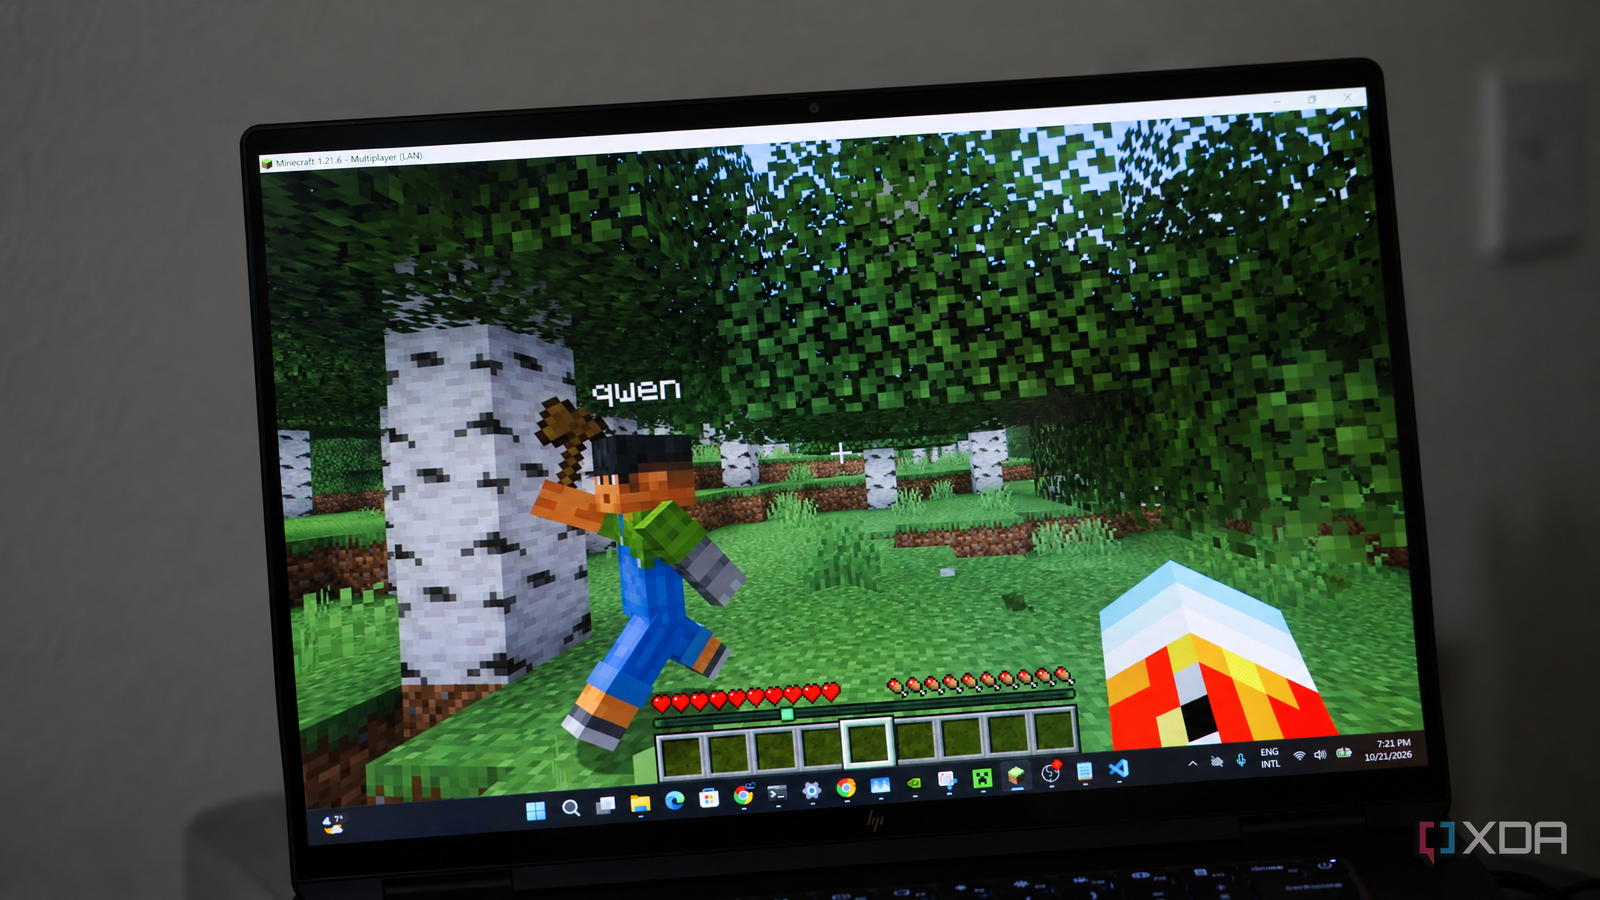
Minecraft diente als Testfeld für KI-Hardware der nächsten Generation: In einem Test, den XDA-Developers am 25. Oktober 2026 beschrieben hat, steuerte das große Sprachmodell Qwen 3.8 Flash Next mit 125 Milliarden Parametern einen Bot im Spiel, während das Spiel selbst auf derselben Maschine stabile 120 FPS hielt. Alles lief auf einem HP OmniBook Ultra 16 mit dem Chip Nvidia RTX Spark, der einen ARM-Prozessor mit 20 Kernen, eine Blackwell-GPU mit 6144 Kernen und 128 GB Unified Memory kombiniert.
So funktioniert Mindcraft
Für die Kommunikation zwischen dem KI-Modell und der Spielwelt sorgt Mindcraft, ein Open-Source-Projekt auf Basis der Bibliothek Mineflayer, die Entwicklern von Minecraft-Bots schon länger bekannt ist. Mindcraft verbindet den Bot wie einen normalen Spieler mit dem Server, und der gesamte Informationsaustausch läuft über den Chat des Spiels. Das LLM steuert die Figur nicht direkt: Es gibt Befehle als Textkommandos aus, zum Beispiel !collectBlocks("birch_log", 10), und Mindcraft übersetzt sie in echte Bewegung, Abbauen oder Inventarverwaltung.
Das Projekt unterstützt außerdem eine einfache Form des Sehens. Der Befehl !lookAtPlayer fängt ein Bild aus der Perspektive des Bots ab, sodass sich das Modell in der Umgebung orientieren kann, ohne Zugriff auf die komplette gerenderte Spielansicht zu haben. Das ist ein anderer Ansatz als bei klassischen Bots mit starren Skriptregeln: Hier entscheidet das Sprachmodell in Echtzeit, was gesammelt wird, wohin es geht und wie auf Gefahren reagiert wird.
Testergebnisse auf dem RTX Spark
Laut dem Artikel von XDA-Developers hielt Minecraft in den meisten Sitzungen rund 120 FPS, obwohl im Hintergrund ein Mixture-of-Experts-Modell mit etwa 6 Milliarden aktiven Parametern pro Token lief. Llama.cpp erzeugte dabei etwa 46 Token pro Sekunde bei kurzem Kontext, bei auf 32.000 Token erweitertem Kontext sank der Wert auf knapp 42 Token pro Sekunde.
- Laptop: HP OmniBook Ultra 16 mit Nvidia RTX Spark
- Speicher: 128 GB Unified VRAM
- KI-Modell: Qwen 3.8 Flash Next, 125 Mrd. Parameter (Mixture-of-Experts)
- Spielleistung: ca. 120 FPS in den meisten Sitzungen
- Modellleistung: 46 Token/s bei kurzem Kontext, ca. 42 Token/s bei 32.000 Token
Der Autor des Tests betonte, dass beide Anwendungen gleichzeitig liefen, ganz ohne spezielle Planung der GPU-Ressourcen. Entscheidend war die Speichergröße: Mit 128 GB Unified VRAM ließ sich das große Modell ohne Kompromisse bei der Größe starten, die der begrenzte Speicher von Grafikkarten normalerweise erzwingt, wenn sie sich zwischen Spiel und KI-Berechnungen aufteilen müssen.
Navigationsfehler, keine Denkfehler
Der Test verlief nicht fehlerfrei. Der Bot machte Fehler bei der Navigation durch die Welt, doch der Autor führt sie auf Einschränkungen der Bibliothek Mineflayer zurück und nicht auf die Qualität der Entscheidungen des Sprachmodells. Das Modell verstand die Textbefehle gut und plante die nächsten Schritte korrekt, etwa das Sammeln bestimmter Rohstoffe oder das Reagieren auf Befehle zur Beobachtung der Umgebung.
Diese Unterscheidung ist wichtig für alle, die eigene KI-Bots für Minecraft bauen wollen: Die Grenze ist nicht die Leistung des Sprachmodells, sondern die Zwischenschicht, die seine Entscheidungen in konkrete Aktionen im Spiel übersetzt. Für Spieler, die auf Servern Automatisierungen bauen und dabei Mods nutzen, die Redstone-Möglichkeiten erweitern, oder Datapacks einsetzen, ist das ein Signal, dass die Grenze heute woanders liegt als noch vor einem Jahr.
Was das für KI-Experimente im Spiel bedeutet
Minecraft ist seit Jahren eine beliebte Testumgebung für künstliche Intelligenz, von klassischen Projekten wie MineRL bis zu neueren Experimenten mit Agenten auf Basis großer Sprachmodelle. Der Test auf dem RTX Spark zeigt, dass Hardware der Workstation-Klasse mit viel Unified Memory es mittlerweile erlaubt, vollwertiges Gameplay mit einem lokalen, großen KI-Modell auf einer einzigen Maschine zu kombinieren, ohne Daten an externe Server zu schicken.
Für Server und Communitys, die eigene Welten mit NPC-Bots oder Automatisierungen bauen, ist das ein Vorgeschmack auf günstigeren Zugang zu lokalen KI-Agenten, die keine dauerhafte Verbindung zur Cloud brauchen. Wer selbst mit einem ähnlichen Setup experimentieren möchte, kann fertige Seeds für die Welt als Ausgangspunkt für Tests mit Erkundungsbots ausprobieren, und die Dokumentation zu Rezepten und Blöcken findet sich in der Crafting-Anleitung der Seite.