 4 min de lecture
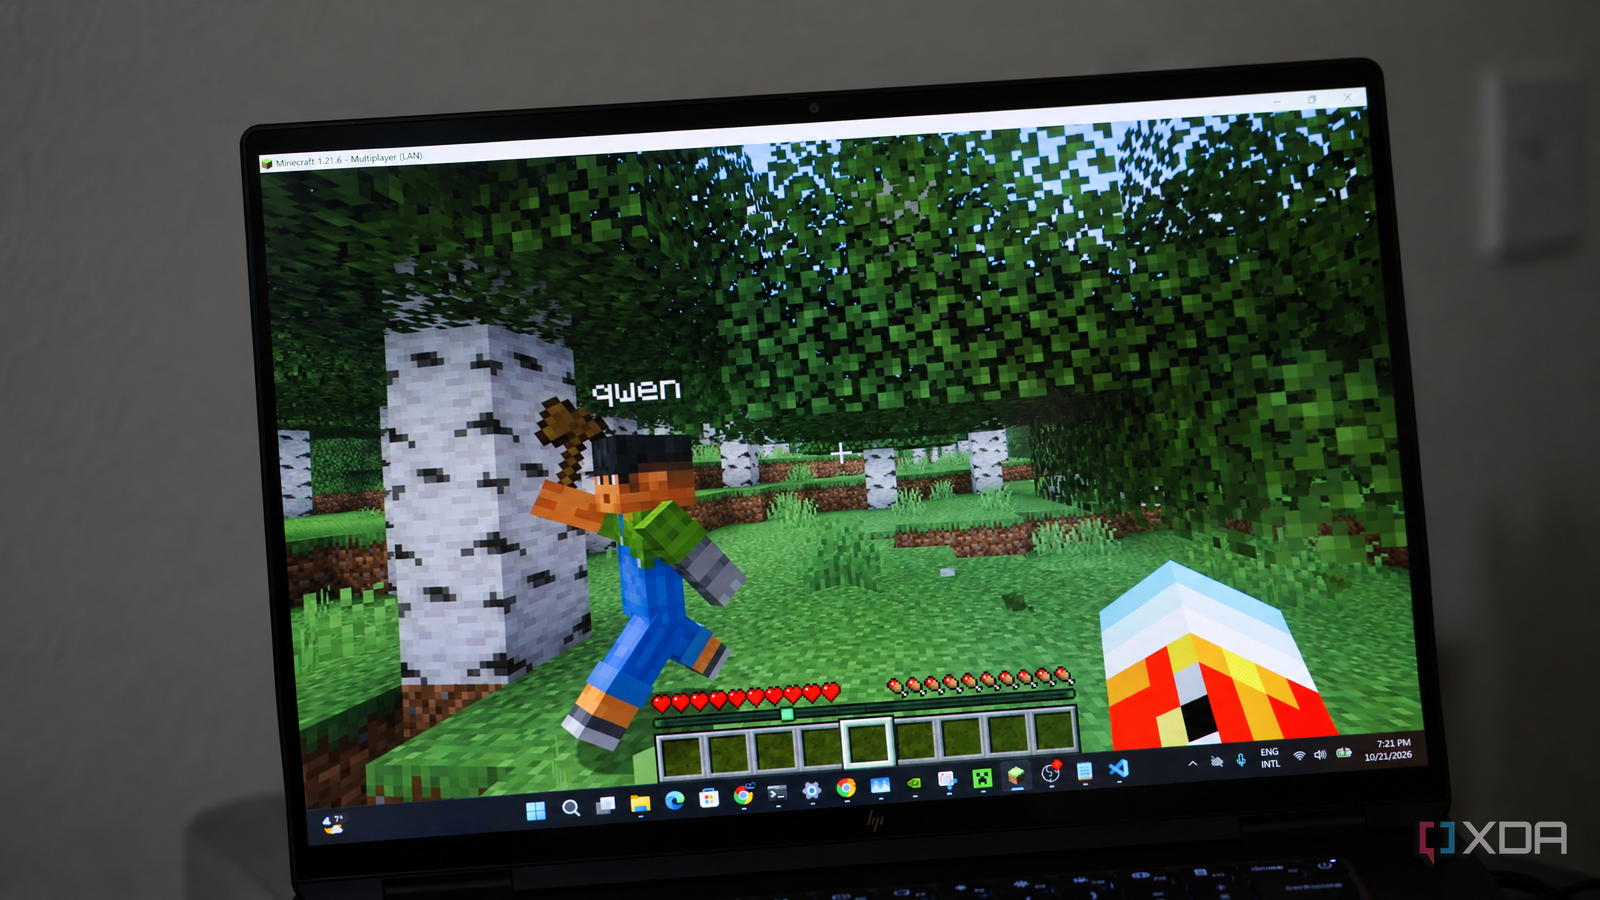
Minecraft a servi de terrain d'essai pour le matériel IA de nouvelle génération : dans un test décrit le 25 octobre 2026 par XDA-Developers, un grand modèle de langage, Qwen 3.8 Flash Next (125 milliards de paramètres), contrôlait un bot dans le jeu, pendant que la partie tournait à 120 FPS stables sur la même machine. Le tout sur un laptop HP OmniBook Ultra 16 équipé d'une puce Nvidia RTX Spark, qui associe un processeur ARM à 20 cœurs, un GPU Blackwell à 6 144 cœurs et 128 Go de mémoire unifiée.
Comment fonctionne Mindcraft
La communication entre le modèle d'IA et le monde du jeu est assurée par Mindcraft, un projet open source construit sur la bibliothèque Mineflayer, déjà bien connue des créateurs de bots pour Minecraft. Mindcraft connecte le bot à un serveur comme un joueur ordinaire, et tous les échanges passent par le chat du jeu. Le LLM ne contrôle pas directement le personnage : il envoie des ordres sous forme de commandes textuelles, par exemple !collectBlocks("birch_log", 10), et Mindcraft les traduit en déplacements, en minage ou en gestion de l'inventaire.
Le projet gère aussi une forme simple de vision. La commande !lookAtPlayer capture l'image du point de vue du bot, ce qui permet au modèle de s'orienter dans son environnement sans avoir accès à la vue complète rendue par le jeu. Cette approche diffère des bots classiques, scriptés selon des règles rigides : ici, c'est le modèle de langage qui décide en temps réel quoi récolter, où aller et comment réagir face aux dangers.
Les résultats du test sur la RTX Spark
Selon l'article de XDA-Developers, Minecraft a gardé environ 120 FPS pendant la majeure partie de la session, alors qu'un modèle mixture-of-experts, avec environ 6 milliards de paramètres actifs par token, tournait en arrière-plan. Llama.cpp générait alors environ 46 tokens par seconde avec un contexte court, et un peu moins de 42 tokens par seconde avec un contexte étendu à 32 000 tokens.
- Laptop : HP OmniBook Ultra 16 avec Nvidia RTX Spark
- Mémoire : 128 Go de VRAM unifiée
- Modèle d'IA : Qwen 3.8 Flash Next, 125 milliards de paramètres (mixture-of-experts)
- Performances du jeu : environ 120 FPS pendant la majeure partie de la session
- Performances du modèle : 46 tokens/s avec un contexte court, environ 42 tokens/s avec 32 000 tokens
L'auteur du test souligne que les deux applications tournaient en même temps, sans aucune planification particulière des ressources du GPU. La clé, c'est la taille de la mémoire : 128 Go de VRAM unifiée ont permis de lancer un gros modèle sans compromis sur sa taille, alors que la mémoire limitée des cartes graphiques, partagée entre le jeu et les calculs d'IA, l'impose normalement.
Des erreurs de navigation, pas de réflexion
Le test n'a pas été parfait. Le bot a fait des erreurs de navigation dans le monde, mais l'auteur les attribue aux limites de la bibliothèque Mineflayer elle-même, et non à la qualité des décisions du modèle de langage. Le modèle comprenait bien les ordres textuels et planifiait correctement les étapes suivantes, comme la récolte de ressources précises ou la réaction aux commandes d'observation de l'environnement.
Cette distinction compte pour celles et ceux qui veulent construire leurs propres bots IA pour Minecraft : la limite ne vient pas de la puissance du modèle de langage, mais de la couche intermédiaire qui traduit ses décisions en actions concrètes dans le jeu. Pour les joueurs qui bâtissent des automatisations sur des serveurs, avec des mods qui étendent les possibilités de la redstone ou des datapacks, c'est le signe que la frontière se situe aujourd'hui ailleurs qu'il y a un an.
Ce que cela change pour les expériences d'IA dans le jeu
Minecraft est depuis des années un environnement de test prisé pour l'intelligence artificielle, des projets classiques comme MineRL aux expériences plus récentes avec des agents basés sur de grands modèles de langage. Le test sur la RTX Spark montre qu'une machine de classe station de travail, dotée d'une grande mémoire unifiée, permet désormais de combiner une vraie partie et un gros modèle d'IA local sur un seul appareil, sans envoyer de données vers des serveurs externes.
Pour les serveurs et les communautés qui construisent leurs mondes avec des bots PNJ ou des automatisations, c'est l'annonce d'un accès moins coûteux à des agents IA locaux, qui n'ont pas besoin d'une connexion permanente au cloud. Si vous voulez expérimenter vous-même avec une configuration similaire, vous pouvez consulter les seeds de monde prêtes à l'emploi comme point de départ pour tester des bots d'exploration, et retrouver la documentation sur les recettes et les blocs dans le guide du craft du site.